最近在梳理 HTTP 协议相关内容,当梳理到追加协议相关内容的时候发现 HTTP/2 所涉及到的内容篇幅还是有些多的,所以就单独提取出来,更多相关内容可以参考 HTTP 协议 和 前端知识体系整理
这里推荐 HTTP/2 这篇文章,个人认为是目前看到的资料里介绍的最全面和详细的,
HTTP/2的二进制帧,多路复用,请求优先级,流量控制,服务器端推送以及首部压缩等新改进都涉及到了,还可以感受一下 https://http2.akamai.com/demo 这个地址,它主要用来比较HTTP/2与HTTP/1.1在性能上的差异
HTTP/2 的前身
HTTP/2 的前身是 HTTP/1.0 和 HTTP/1.1,虽然之前仅仅只有两个版本,但这两个版本所包含的协议规范之庞大,足以让任何一个有经验的工程师为之头疼,HTTP/1.0 诞生于 1996 年,协议文档足足 60 页,之后第三年,HTTP/1.1 也随之出生,协议文档膨胀到了 176 页,但是网络协议新版本并不会马上取代旧版本,实际上 HTTP/1.0 和 HTTP/1.1 在之后很长的一段时间内一直并存,这是由于网络基础设施更新缓慢所决定的,今天的 HTTP/2 也是一样,新版协议再好也需要业界的产品锤炼,需要基础设施逐年累月的升级换代才能普及
HTTP 站在 TCP 之上
理解 HTTP 协议之前一定要对 TCP 有一定的了解,HTTP 是建立在 TCP 协议之上,TCP 协议作为传输层协议其实离应用层并不远,HTTP 协议的瓶颈及其优化技巧都是基于 TCP 协议本身的特性,比如 TCP 建立连接时三次握手有 1.5 个 RTT(来回时间)的延迟,为了避免每次请求的都经历握手带来的延迟,应用层会选择不同策略的 HTTP 长链接方案,又比如 TCP 在建立连接的初期有慢启动(slow start)的特性,所以连接的重用总是比新建连接性能要好
HTTP 应用场景
HTTP 诞生之初主要是应用于 Web 端内容获取,对于早些时期简单的获取网页内容的场景,HTTP 表现得还算不错,但随着互联网的发展和 Web 2.0 的诞生,更多的内容开始被展示(比如更多的的图片文件,CSS,JavaScript 等),用户打开一个网站首页所加载的数据总量和请求的个数也在不断增加,今天绝大部分的门户网站首页大小都会超过 2M,请求数量可以多达 100 个,另一个广泛的应用场景就是在移动端,比如对于电商类 App,加载首页的请求也可能多达几十个
带宽和延迟
影响一个网络请求的因素主要有两个,带宽和延迟,今天的网络基础建设已经使得带宽得到极大的提升,大部分时候都是延迟在影响响应速度,HTTP/1.0 被抱怨最多的就是连接无法复用,和队头阻塞这两个问题,理解这两个问题有一个十分重要的前提就是客户端是依据域名来向服务器建立连接,一般浏览器会针对单个域名的服务器同时建立六到八个连接,而移动端的连接数则一般控制在四到六个,显然连接数并不是越多越好,资源开销和整体延迟都会随之增大
连接无法复用会导致每次请求都经历三次握手和慢启动,三次握手在高延迟的场景下影响较明显,慢启动则对文件类大请求影响较大,队头阻塞会导致带宽无法被充分利用,以及后续健康请求被阻塞,假设有五个请求同时发出,如下图
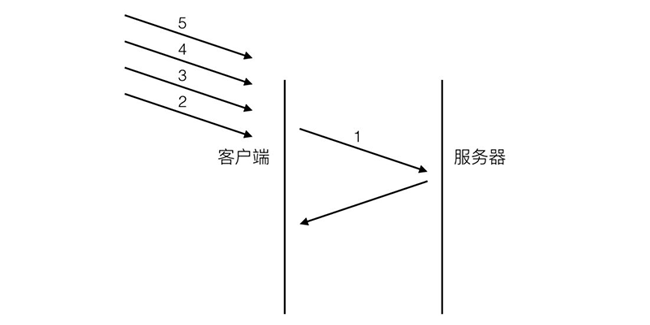
对于 HTTP/1.1 的实现,在第一个请求没有收到回复之前,后续从应用层发出的请求只能排队,请求 2,3,4,5 只能等待请求 1 的响应回来之后才能逐个发出,网络通畅的时候性能影响不大,一旦请求 1 因为什么原因没有抵达服务器,或者响应因为网络阻塞没有及时返回,影响的就是所有后续请求
解决连接无法复用
HTTP/1.0 协议头里可以设置 Connection: keep-alive,在 Header 里设置 keep-alive 可以在一定时间内复用连接,具体复用时间的长短可以由服务器控制,一般在 15s 左右,到 HTTP/1.1 之后,Connection 的默认值就是 keep-alive,如果要关闭连接复用需要显式的设置 Connection: close,一段时间内的连接复用对电脑端的浏览器体验帮助很大,因为大部分的请求在集中在一小段时间以内,但对与移动端来说,成效不大,因为移动端的请求比较分散且时间跨度相对较大,所以移动端一般会从应用层寻求其它解决方案,比如长连接方案或者伪长连接方案
基于 TCP 的长链接
这种方式是建立一条自己的长链接通道,通道的实现是基于 TCP 协议,基于 TCP 的 Socket 编程技术难度相对复杂很多,而且需要自己制定协议,但带来的回报也很大,信息的上报和推送变得更及时,在请求量爆发的时间点还能减轻服务器压力(HTTP 短连接模式会频繁的创建和销毁连接)
长轮询
HTTP 长轮询可以用下图表示

客户端在初始状态就会发送一个轮询请求到服务器,服务器并不会马上返回业务数据,而是等待有新的业务数据产生的时候再返回,所以连接会一直被保持,一旦结束马上又会发起一个新的轮询请求,如此反复,所以一直会有一个连接被保持,服务器有新的内容产生的时候,并不需要等待客户端建立一个新的连接,使用长轮询的好处以及需要注意的地方有以下这些
- 和传统的
HTTP短链接相比,长连接会在用户增长的时候极大的增加服务器压力 - 移动端网络环境复杂,像
Wi-Fi和4G之类的网络切换,进电梯导致网络临时断掉等,这些场景都需要考虑怎么重建健康的连接通道 - 这种轮询的方式稳定性并不好,需要做好数据可靠性的保证,比如重发和
ACk机制(消息确认机制) - 轮询的响应有可能会被中间代理缓存,要处理好业务数据的过期机制
长轮询方式还有一些缺点是无法克服的,比如每次新的请求都会带上重复的 Header 信息,还有数据通道是单向的,主动权掌握在服务端这边,客户端有新的业务请求的时候无法及时传送
流
HTTP 流的过程大致是下面这样的
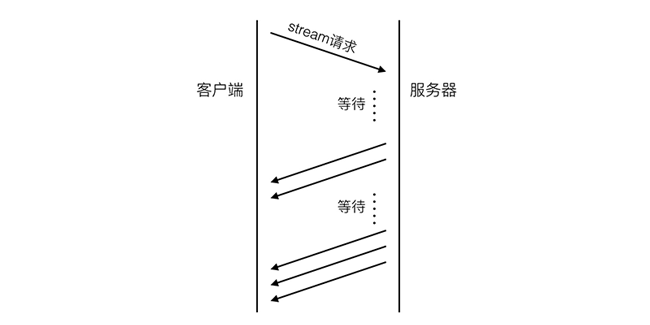
同长轮询不同的是,服务端并不会结束初始的流请求,而是持续的通过这个通道返回最新的业务数据,显然这个数据通道也是单向的,流是通过在服务端响应的头部里增加 Transfer Encoding: chunked 来告诉客户端后续还会有新的数据到来,除了和长轮询相同的难点之外,流还有几个缺陷
- 有些代理服务器会等待服务器的响应结束之后才会将结果推送到请求客户端,对于流这种永远不会结束的方式来说,客户端就会一直处于等待响应的过程中
- 业务数据无法按照请求来做分割,所以客户端没收到一块数据都需要自己做协议解析,也就是说要做自己的协议定制
关于
HTTP流的更为详细的内容,我们会在下面的HTTP/2章节当中进行介绍
WebSocket
WebSocket 和传统的 TCP Socket 连接相似,也是基于 TCP 协议,提供双向的数据通道,比基于字节流的 TCP Socket 使用更简单,同时又提供了传统的 HTTP 所缺少的长连接功能
解决队头阻塞
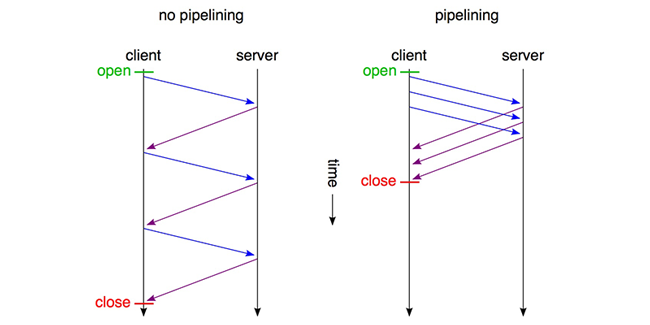
队头阻塞是 HTTP/2 之前网络体验的最大祸源,正如上面带宽和延迟章节当中的图片所示,健康的请求会被不健康的请求影响,而且这种体验的损耗受网络环境影响,出现随机且难以监控,为了解决队头阻塞带来的延迟,协议设计者设计了一种新的 HTTP 管线化机制(pipelining),管线化的流程图可以用下图表示
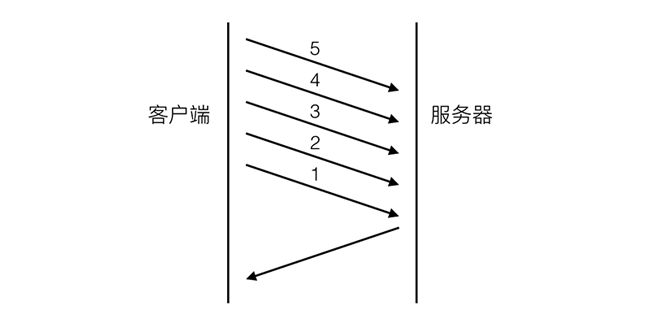
和之前相比最大的差别是,请求 2,3,4,5 不需要等待请求 1 的响应返回之后才发出,而是几乎在同一时间就把请求发向了服务器,2,3,4,5 及所有后续共用该连接的请求节约了等待的时间,极大的降低了整体延迟,下图可以清晰的看出这种新机制对延迟的改变
不过管线化并不是完美的,它也存在不少缺陷
- 管线化只能适用于
HTTP/1.1,一般来说,支持HTTP/1.1的服务端都要求支持管线化 - 只有幂等的请求(
GET,HEAD)能使用管线化,非幂等请求比如POST不能使用,因为请求之间可能会存在先后依赖关系 - 队头阻塞并没有完全得到解决,服务端的响应还是要求依次返回,遵循
FIFO(first in first out)原则,也就是说如果请求1的响应没有回来,2,3,4,5的响应也不会被送回来 - 绝大部分的
HTTP代理服务器不支持管线化
正是因为有这么多的问题,各大浏览器厂商要么是根本就不支持管线化,要么就是默认关掉了管线化机制,而且启用的条件十分苛刻,可以参考 Chrome 对于管线化的 问题描述
开拓者 SPDY
HTTP/1.0 和 HTTP/1.1 虽然存在这么多问题,业界也想出了各种优化的手段,但这些方法手段都是在尝试绕开协议本身的缺陷,直到 2012 年 Google 提出了 SPDY 的方案,大家才开始从正面看待和解决老版本 HTTP 协议本身的问题,这也直接加速了 HTTP/2 的诞生,实际上 HTTP/2 是以 SPDY 为原型进行讨论和标准化的
SPDY 的目标
SPDY 的目标在一开始就是瞄准老版本所存在的一些痛点,即延迟和安全性,关于延迟我们在上面已经介绍过了,至于安全性,由于 HTTP 是明文协议,其安全性也一直被业界诟病,如果以降低延迟为目标,应用层的 HTTP 和传输层的 TCP 都是都有调整的空间,不过 TCP 作为更底层协议存在已达数十年之久,其实现已深植全球的网络基础设施当中,所以 SPDY 的瞄准的就是 HTTP,主要有以下几点
- 降低延迟,客户端的单连接单请求,服务端的
FIFO响应队列都是延迟的大头 HTTP最初设计都是客户端发起请求,然后服务端响应,所以服务端无法主动推送内容到客户端- 头部压缩,
Cookie和User-Agent很容易让Header的大小增加,而且由于HTTP的无状态特性,Header必须每次请求都重复携带,很浪费流量
为了增加业界响应的可能性,聪明的 Google 一开始就避开了从传输层动手,对于协议使用者来说,也只需要在请求的 Header 里设置 User-Agent,然后在服务端端做好支持即可,极大的降低了部署的难度, SPDY 的设计如下
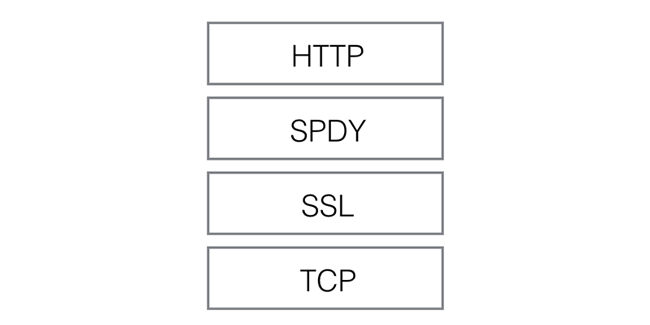
SPDY 位于 HTTP 之下,TCP 和 SSL 之上,这样可以轻松兼容老版本的 HTTP 协议,同时可以使用已有的 SSL 功能,SPDY 的功能可以分为基础功能和高级功能两部分,基础功能默认启用,高级功能需要手动启用,它们有以下这些
- 基础功能
- 多路复用(
multiplexing),多路复用通过多个请求流共享一个TCP连接的方式,解决了队头阻塞的问题,降低了延迟同时提高了带宽的利用率 - 请求优先级(
request prioritization),多路复用带来一个新的问题是,在连接共享的基础之上有可能会导致关键请求被阻塞,SPDY允许给每个请求设置优先级,这样重要的请求就会优先得到响应,比如浏览器加载首页,首页的HTML内容应该优先展示,之后才是各种静态资源文件,脚本文件等加载,这样可以保证用户能第一时间看到网页内容 Header压缩,选择合适的压缩算法可以减小包的大小和数量,SPDY对Header的压缩率可以达到80%以上,低带宽环境下效果很大
- 多路复用(
- 高级功能
- 服务端推送,最初只能由客户端发起请求,然后服务器被动的发送响应,开启服务端推送之后,服务端通过在
Header中添加X-Associated-Content头域(X开头的Header都属于非标准的,自定义Header)告知客户端会有新的内容推送过来,在用户第一次打开网站首页的时候,服务端将资源主动推送过来可以极大的提升用户体验 - 服务端暗示,和服务端推送不同的是,服务端暗示并不会主动推送内容,只是告诉有新的内容产生,内容的下载还是需要客户端主动发起请求,服务端暗示通过在
Header中添加X-Subresources头域来通知,一般应用场景是客户端需要先查询服务端状态,然后再下载资源,可以节约一次查询请求
- 服务端推送,最初只能由客户端发起请求,然后服务器被动的发送响应,开启服务端推送之后,服务端通过在
SPDY 的效果
SPDY 的成绩可以用 Google 官方的一个数字来说明,页面加载时间减少了 64%,Google 的官网也给出了他们自己做的一份测试数据,测试对象是 25 个访问量排名靠前的网站首页,每个网站测试 10 次取平均值,结果如下
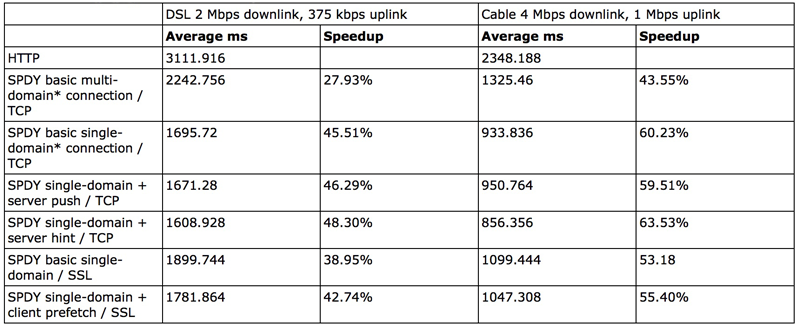
不开启 SSL 的时候提升在 27% ~ 60%,开启之后为 39% ~ 55%, 这份测试结果有两点值得特别注意
- 连接数的选择,连接到底是基于域名来建立,还是不做区分所有子域名都共享一个连接,这个策略选择上值得商榷,
Google的测试结果测试了两种方案,看结果似乎是单一连接性能高于多域名连接方式,之所以出现这种情况是由于网页所有的资源请求并不是同一时间发出,后续发出的子域名请求如果能复用之前的TCP连接当然性能更好,实际应用场景下应该也是单连接共享模式表现好 - 带宽的影响,测试基于两种带宽环境,一慢一快,网速快的环境下对减小延迟的提升更大,单连接模式下可以提升至
60%,原因也比较简单,带宽越大,复用连接的请求完成越快,由于三次握手和慢启动导致的延迟损耗就变得更明显
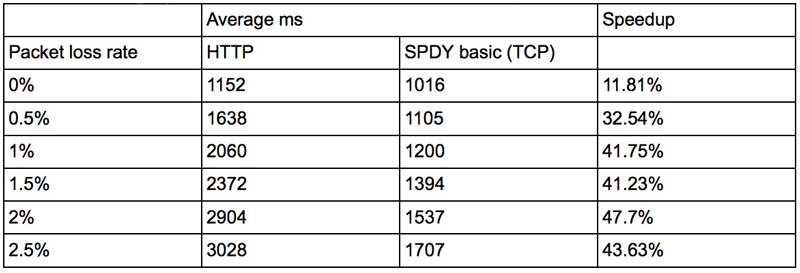
除了连接模式和带宽之外,丢包率和 RTT 也是需要测试的参数,SPDY 对 Header 的压缩有 80% 以上,整体包大小能减少大概 40%,发送的包越少,自然受丢包率影响也就越小,所以丢包率大的恶劣环境下 SPDY 反而更能提升体验,下图是受丢包率影响的测试结果,丢包率超过 2.5% 之后就没有提升了
RTT 越大,延迟会越大,在高 RTT 的场景下,由于 SPDY 的请求是并发进行的,所有对包的利用率更高,反而能更明显的减小总体延迟,测试结果如下
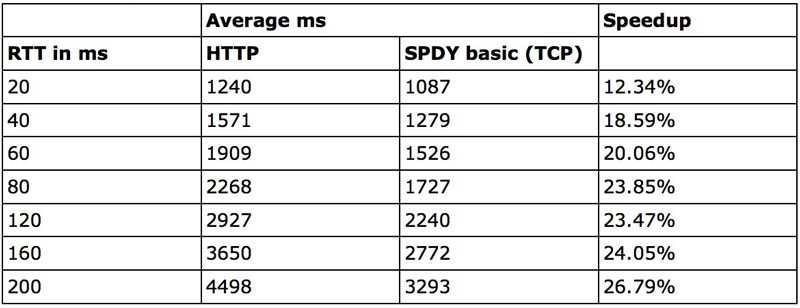
不过 SPDY 从 2012 年诞生到 2016 停止维护,只有短短的四年,时间跨度对于网络协议来说其实非常之短,但 SPDY 也在某种意义上算是完成了自己的使命
HTTP/2
SPDY 的诞生和表现说明了两件事情,一是在现有互联网设施基础和 HTTP 协议广泛使用的前提下,是可以通过修改协议层来优化的,二是修改确实效果明显而且业界反馈很好,正是这两点让 IETF(Internet Enginerring Task Force)开始正式考虑制定 HTTP/2 的计划,最后决定以 SPDY/3 为蓝图起草 HTTP/2,SPDY 的部分设计人员也被邀请参与了 HTTP/2 的设计
HTTP/2 需要考虑的问题
HTTP/1.0 最早在网页中使用是在 1996 年,那个时候只是使用一些较为简单的网页上和网络请求上,而 HTTP/1.1 则在 1999 年才开始广泛应用于现在的各大浏览器网络请求中,同时 HTTP/1.1 也是当前使用最为广泛的 HTTP 协议
HTTP/0.9,只支持GET方法,不支持多媒体内容的MIME类型、各种HTTP首部,或者版本号,只是为了获取HTML对象HTTP/1.0,添加了版本号、各种HTTP首部、一些额外的方法,以及对多媒体对象的处理HTTP/1.0+,keep-alive连接、虚拟主机支持,以及代理连接支持都被加入到HTTP之中等等HTTP/1.1,主要有下面几个部分- 缓存处理,在
HTTP/1.0中主要使用Header里的If-Modified-Since,Expires来做为缓存判断的标准,HTTP/1.1则引入了更多的缓存控制策略例如Entity tag,If-Unmodified-Since,If-Match,If-None-Match等更多可供选择的缓存头来控制缓存策略 - 在请求头引入了
Range头域,它允许只请求资源的某个部分,即返回码是206(Partial Content) - 错误通知的管理,新增了
24个错误状态响应码,如409(Conflict)表示请求的资源与资源的当前状态发生冲突,410(Gone)表示服务器上的某个资源被永久性的删除等 Host头处理,HTTP/1.1的请求消息和响应消息都应支持Host头域,且请求消息中如果没有Host头域会报告一个错误(400 Bad Request)- 长连接,
HTTP/1.1支持长连接和管线化处理,也就是Connection: keep-alive
- 缓存处理,在
而 HTTP/2 在此基础之上被寄予了如下期望,希望能够
- 相比于使用
TCP的HTTP/1.1,最终用户可感知的多数延迟都有能够量化的显著改善 - 解决
HTTP中的队头阻塞问题 - 并行的实现机制不依赖与服务器建立多个连接,从而提升
TCP连接的利用率,特别是在拥塞控制方面 - 保留
HTTP/1.1的语义,可以利用已有的文档资源,包括HTTP方法、状态码、URI和首部字段等
连接
连接是所有 HTTP/2 会话的基础元素,其定义是客户端初始化的一个 TCP/IP Socket,客户端是指发送 HTTP 请求的实体,这和 HTTP/1.1 是一样的,不过与完全无状态的 HTTP/1.1 不同的是,HTTP/2 把它所承载的帧(frame)和流(stream)共同依赖的连接层元素捆绑在一起,其中既包含连接层设置也包含首部表
为了向服务器双重确认客户端支持 HTTP/2,客户端会发送一个叫作 Connection Preface 字节流,作为连接的第一份数据,这主要是为了应对客户端通过纯文本的 HTTP/1.1 升级上来的情况,该字节流用十六进制表示如下
1 | 0x505249202a20485454502f322e300d0a0d0a534d0d0a0d0a |
解码为 ASCII 是
1 | PRI * HTTP/2.0\r\n\r\nSM\r\n\r\n |
这个字节流的用处是,如果服务器(或者中间网络设备)不支持 HTTP/2,就会产生一个显式错误,这个消息特意设计成 HTTP/1.1 消息的样式,如果运行良好的 HTTP/1.1 服务器收到这个字节流,它会阻塞这个方法,并返回错误,可以让 HTTP/2 客户端明确地知道发生了什么错误
这个字节流会有一个 SETTINGS 帧紧随其后,服务器为了确认它可以支持 HTTP/2,会声明收到客户端的 SETTINGS 帧,并返回一个它自己的 SETTINGS 帧(反过来也需要确认),然后确认环境正常,可以开始使用 HTTP/2(关于 SETTINGS 帧相关概念,我们会在下面进行介绍)
帧
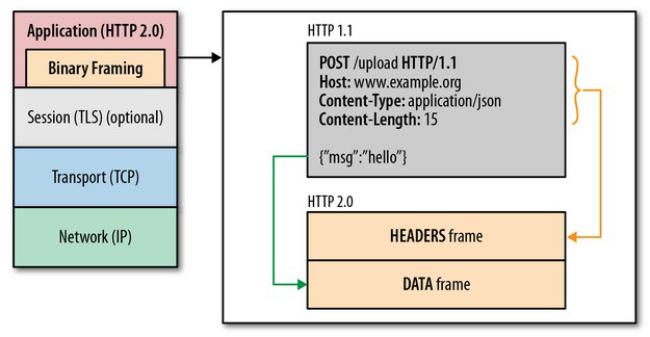
HTTP/2 是基于帧的协议,采用分帧是为了将重要信息都封装起来,让协议的解析方可以轻松阅读、解析并还原信息, 相比之下,HTTP/1.1 不是基于帧的,而是以文本分隔,看看下面的简单例子
1 | GET / HTTP/1.1 <crlf> |
解析这种数据往往速度慢且容易出错,需要不断读入字节,直到遇到分隔符为止,同时还要考虑一些并不是按照规矩来进行发送的客户端,所以解析 HTTP/1.1 的请求或响应可能出现下列问题
- 一次只能处理一个请求或响应,完成之前不能停止解析
- 无法预判解析需要多少内存,这会带来一系列问题,例如需要把一行读到多大的缓冲区里,如果行太长会应该增加并重新分配内存,还是返回
400错误?
为了解决这些问题,保持内存处理的效率和速度可不简单,从另一方面来说,有了帧,处理协议的程序就能预先知道会收到什么,基于帧的协议,特别是 HTTP/2,开始有固定长度的字节,其中包含表示整帧长度的字段
下面我们就稍微深入的来了解一下 HTTP/2 当中帧的概念,这里主要涉及到帧大小,帧格式和帧定义
帧大小
帧载荷的大小受接收者在 SETTINGS_MAX_FRAME_SIZE 设定的最大大小限制,值的范围为 2^14 至 2^24 - 1,包含所有的实现要必须能够接收并最低限度地处理长度最大在 2^14 字节的帧,外加 9 个字节的帧首部,当描述帧大小时,帧首部的大小不会被包含在内
这里需要注意,某些帧类型,比如
ING,会对允许的载荷数据的大小强加额外的限制
如果一个帧超出了 SETTINGS_MAX_FRAME_SIZE 定义的大小,超出了为帧类型定义的任何限制,或者太小以至于无法包含必要的帧数据,终端必须发送一个错误码 FRAME_SIZE_ERROR,可能改变整个连接状态的帧中的帧大小错误必须被当作一个连接错误,这包括所有携带首部块的帧(即 HEADERS,PUSH_PROMISE,CONTINUATION,SETTINGS 和所有流标识符为 0 的帧)
终端没有义务用完帧中的所有的可用空间,响应能力可以通过使用比允许的最大大小小的帧来提升,在发送时间敏感的帧时发送大帧可能导致延时(比如 RST_STREAM,WINDOW_UPDATE 或 PRIORITY),如果传输由于一个大的帧而阻塞,则可能会影响性能
帧格式
所有的帧都以一个固定的 9 字节首部开始,其后紧跟一个可变长度的载荷,如下
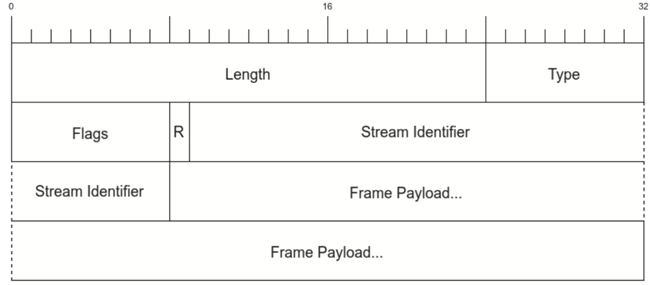
也可以简化为下面这样
1 | +-----------------------------------------------+ |
下面我们来看看它们各部分之间的含义
| 名称 | 字节数 | 释义 |
|---|---|---|
Length |
3 字节 |
帧载荷的长度,以一个无符号 24 位整数表示,2^14 字节是默认的最大帧大小,如果需要更大的帧,必须在 SETTINGS 帧中设置 |
Type |
1 字节 |
当前帧类型,帧类型决定了帧的格式和语义,HTTP/2 实现必须忽略并丢弃未知类型的帧 |
Flags |
1 字节 |
具体帧类型的标识,一个特定于帧类型的 8 位 boolean 标记保留字段 |
R |
1 位 |
保留位,无需设置,否则可能带来严重后果 |
Stream Identifier |
31 位 |
流标识符,被表示为一个 31 位无符号整型值 |
Frame Payload |
可变 | 真实的帧内容,长度是在 Length 字段中设置的 |
HTTP/1.1 有个特性叫管线化,允许一次发送一组请求,但是只能按照发送顺序依次接收响应,而且管线化备受互操作性和部署的各种问题的困扰,在请求应答过程中,如果出现任何状况,剩下所有的工作都会被阻塞在那次请求应答之后,这就是队头阻塞,它会阻碍网络传输和 Web 页面渲染,直至失去响应,但是由于 HTTP/2 是分帧的,请求和响应可以交错甚至多路复用,多路复用有助于解决类似队头阻塞的问题
帧定义
HTTP/2 中定义了多种帧类型,每种都有一个唯一的 8 位类型码标识,每种帧类型都有不同的目的,特定帧类型的传输可能改变连接的状态,如果终端不能维护连接状态视图的一致性,连接内成功的通信将是不可能的,因此终端之间,关于特定帧的使用对状态所产生的影响具有相同的理解就变得非常重要
DATA 帧
DATA 帧(type = 0x0)传送与一个流关联的任意的可变长度的字节序列,一个或多个 DATA 帧被用于携带 HTTP 请求或响应载荷,DATA 帧也可以包含填充字节,填充字节可以被加进 DATA 帧来掩盖消息的大小,填充字节是一个安全性的功能
1 | +---------------+ |
| 名称 | 解释 | 含义 |
|---|---|---|
Pad Length |
填充长度 | 一个 8 位的字段,包含了以字节为单位的帧的填充的长度,这个字段是有条件的,只有在 PADDED 标记设置时才出现 |
Data |
数据 | 应用数据,数据的大小是帧载荷减去出现的其它字段的长度剩余的大小 |
Padding |
填充 | 填充字节包含了无应用语义的值,当填充时填充字节必须被设置为 0,接收者没有义务去验证填充可以将非零的填充当做一个类型为 PROTOCOL_ERROR 的连接错误 |
标志
DATA 帧定义了如下的标记
END_STREAM(0x1),当设置了这个标记时,位0表示这个帧是终端将为标识的流发送的最后一帧,设置这个标记使得流进入某种Half-Closed状态或Closed状态PADDED(0x8),当设置了这个标记时,位3表示上面描述的填充长度字段及填充存在
流
DATA帧必须与一个流关联,如果收到了一个流标识符为0x0的DATA帧,接收者必须以一个类型为PROTOCOL_ERROR的连接错误来响应DATA帧受控于flow control,而且只能在流处于open或Half-Closed (remote)状态时发送,整个的DATA帧载荷被包含在flow control中,可能包括填充长度和填充字段,如果收到DATA帧的流不处于open或Half-Closed (remote)状态,则接收者必须以一个类型为STREAM_CLOSED的流错误来响应- 填充字节的总大小由填充长度字段决定,如果填充的长度是帧载荷的长度或更大,则接收者必须将这作为一个类型为
PROTOCOL_ERROR的连接错误来处理应
这里需要注意的是,一个帧可以通过包含一个值为零的填充长度字段来使帧长度只增加一个字节
HEADERS 帧
HEADERS 帧(type = 0x1)用于打开一个流,此外还携带一个 Header 块片段,HEADERS 帧可以在状态为 idle,Reserverd (local),open,或 Half-Closed (remote) 的流上发送
1 | +---------------+ |
HEADERS 帧具有如下的字段
| 名称 | 解释 | 含义 |
|---|---|---|
Pad Length |
填充长度 | 一个 8 位的字段,包含了以字节为单位的帧的填充的长度,只有在 PADDED 标记设置时才出现 |
E |
单 bit 的标记 |
指示流依赖是独占的,这个字段只有在 PRIORITY 标记设置时才会出现 |
Stream Dependency |
流依赖 | 31 位的流标识符,标识这个流依赖的流,这个字段只有在 PRIORITY 标记设置时才会出现 |
Weight |
权重 | 无符号 8 位整型值,表示流的优先级权重,将值加 1 以获得介于 1 和 256 之间的权重这个字段只有在 PRIORITY 标记设置时才会出现 |
Header Block Fragment |
请求头片段 | - |
Padding |
填充 | - |
标志
HEADERS 帧定义了如下的标记
END_STREAM(0x1),当设置时,位0表示这个Header块是终端将是被标识的流发送的最后一个块,HEADERS帧可以携带END_STREAM标记,标明流的结束,然而在相同的流上,一个设置了END_STREAM标记的HEADERS帧后面可以跟着CONTINUATION帧,逻辑上来说CONTINUATION帧是HEADERS帧的一部分END_HEADERS(0x4)若设置,位2指示该帧包含整个头部块,并且没有任何CONTINUATION帧,没有END_HEADERS标记集的HEADERS帧必须跟随同一个流的CONTINUATION帧,接收方必须将接收到的任何其他类型的帧或不同流上的帧视为PROTOCOL_ERROR类型的连接错误PADDED(0x8)若设置,位3指示Pad Length字段及其描述的填充符存在PRIORITY(0x20)若设置,位5指示存在专用标志(E),流依赖性和权重字段
载荷
HEADERS帧的载荷包含一个Header块片段,不适合放在HEADERS帧中的Header块在CONTINUATION帧中继续,HEADERS帧必须与流关联,如果收到的流标识符字段为0x0的HEADERS帧,收件人必须响应PROTOCOL_ERROR类型的连接错误HEADERS帧可以包含填充,填充字段和标志与为DATA帧定义的填充字段和标志相同,填充超过Header分段的剩余大小必须被视为PROTOCOL_ERRORHEADERS帧中的优先级信息在逻辑上等同于单独的PRIORITY帧,但包含在HEADERS中可避免在创建新流时在流优先级中进行流失的可能性,流之后的HEADERS帧中的优先级字段重新设置流的优先顺序
PRIORITY 帧
PRIORITY 帧(type = 0x2)指定了流发送者建议的优先级,它可以以任何流状态发送,包括空闲或封闭的流
1 | +-+-------------------------------------------------------------+ |
PRIORITY 帧的有效载荷包含以下字段
| 名称 | 解释 | 含义 |
|---|---|---|
Pad Length |
填充长度 | 一个 8 位的字段,包含了以字节为单位的帧的填充的长度,只有在 PADDED 标记设置时才出现 |
E |
单 bit 的标记 |
表示流依赖性是唯一的单比特标志 |
Stream Dependency |
流依赖 | 该数据流依赖的流的 31 位流标识符 |
Weight |
权重 | 一个无符号的 8 位整数,表示流的优先级权重,将值加 1 以获得介于 1 和 256 之间的权重 |
标志
PRIORITY 帧不定义任何标志
负载
PRIORITY帧始终标识一个流,如果接收到一个流标识符为0x0的PRIORITY帧,接收方必须响应PROTOCOL_ERROR类型的连接错误PRIORITY帧可以在任何状态下的流上发送,尽管它不能在构成单个Header块的连续帧之间发送,请注意,此帧可能在处理完成或帧发送完成后到达,这会导致它对已识别的流没有任何影响,对于处于Half-Closed (remote)或Closed状态的流,此帧只能影响对已识别流及其依赖流的处理,它不会影响该流上的帧传输PRIORITY帧可以从处于idle或Closed状态的流中发送,这允许通过改变未使用或已关闭的父流的优先级来重新设置一组从属流的优先级,长度不是5个字节的PRIORITY帧必须被视为类型为FRAME_SIZE_ERROR的流错误
RST_STREAM 帧
RST_STREAM 帧(type = 0x3)允许立即终止一个流,发送 RST_STREAM 以请求取消流或指示发生了错误情况
1 | +---------------------------------------------------------------+ |
RST_STREAM 帧包含标识错误代码的单个无符号的 32 位整数,错误代码指示流被终止的原因
标志
RST_STREAM 帧不定义任何标志
说明
RST_STREAM帧完全终止流并使其进入close状态,在流上接收到RST_STREAM之后,接收者不得为该流发送额外的帧,但PRIORITY除外,但是在发送RST_STREAM之后,发送端点务必准备好接收和处理在RST_STREAM到达之前可能已经由对端在流上发送的帧RST_STREAM帧必须与一个流相关联,如果接收到RST_STREAM帧且流标识符为0x0,则接收方必须将其视为PROTOCOL_ERROR类型的连接错误RST_STREAM帧不得在idle状态下发送流,如果接收到标识空闲流的RST_STREAM帧,接收者必须将其视为类型为PROTOCOL_ERROR的连接错误- 长度不是
4个字节的RST_STREAM帧必须被视为FRAME_SIZE_ERROR类型的连接错误
SETTINGS 帧
SETTINGS 帧(type = 0x4)的有效载荷由零个或多个参数组成,每个参数由一个无符号的 16 位设置标识符和一个无符号的 32 位值组成
1 | +-------------------------------+ |
如下参数定义
| 名称 | 含义 |
|---|---|
SETTINGS_HEADER_TABLE_SIZE(0x1) |
允许发送者以字节的形式通知远程端点用于解码 Header 块的 Header 压缩表的最大尺寸,编码器可以通过使用特定于 Header 块内头部压缩格式的信令来选择等于或小于此值的任何大小 |
SETTINGS_ENABLE_PUSH(0x2) |
此设置可用于禁用服务器推送,如果一个端点接收到这个参数设置为 0 的值,它不应该发送一个 PUSH_PROMISE 帧,一个端点既将这个参数设置为 0,并且确认它也必须将 PUSH_PROMISE 帧的接收视为类型为 PROTOCOL_ERROR 的连接错误,初始值为 1,表示允许服务器推送,除 0 或 1 以外的任何值必须视为 PROTOCOL_ERROR 类型的连接错误 |
SETTINGS_MAX_CONCURRENT_STREAMS(0x3) |
表示发件人允许的最大并发流数,这个限制是有方向性的,它适用于发送者允许接收者创建的数据流,最初这个值没有限制,建议此值不小于 100,以免不必要地限制并行性,值为 0 的 SETTINGS_MAX_CONCURRENT_STREAMS 不应被视为特殊的端点,零值确实会阻止创建新的流,然而这也可能发生在活动流所耗尽的任何限制上,服务器应该只在短时间内设置一个零值,如果服务器不希望接受请求,关闭连接更合适 |
SETTINGS_INITIAL_WINDOW_SIZE(0x4) |
指示发送者的流级别流控制的初始窗口大小(以八位字节为单位),初始值是 2^16 - 1 个八位组,该设置会影响所有流的窗口大小,高于最大流量控制窗口大小 2^31 - 1 的值必须视为 FLOW_CONTROL_ERROR 类型的连接错误 |
SETTINGS_MAX_FRAME_SIZE(0x5) |
指示发送者愿意接收的最大帧有效载荷的大小,以八位字节为单位,初始值是 2^14 个八位字节,端点通告的值必须在该初始值和最大允许帧大小之间,包括在内,此范围之外的值务必视为 PROTOCOL_ERROR 类型的连接错误 |
SETTINGS_MAX_HEADER_LIST_SIZE(0x6) |
此通报设置以八位字节的形式通知对等方发送方准备接受的header列表的最大大小,该值基于header字段的未压缩大小,包括名称和八位字节的值的长度,以及每个 Header 字段的开销 32 个字节,对于任何给定的请求,可能会强制实施一个比所宣传的更低的限制,此设置的初始值是无限的,接收到带有任何未知或不支持标识符的 SETTINGS 帧的端点必须忽略该设置 |
说明
SETTINGS帧传达影响端点通信方式的配置参数,例如对对等行为的偏好和约束,SETTINGS帧也用于确认收到这些参数,SETTINGS参数不协商,它们描述了发送端的特征,被接收端使用,每个对等体可以通告相同参数的不同值,例如客户端可能会设置较高的初始流量控制窗口,而服务器可能会设置较低的值以节省资源- 设置帧必须在连接开始时由两个端点发送,并且可以在连接的整个生命周期内由任一端点在任何其他时间发送,实现必须支持本规范定义的所有参数
SETTINGS帧中的每个参数都会替换该参数的任何现有值,参数按它们出现的顺序进行处理,并且SETTINGS帧的接收者不需要保持除参数当前值以外的任何状态,因此SETTINGS参数的值是接收器看到的最后一个值SETTINGS参数由接收方确认,为了实现这一点,SETTINGS帧定义了ACK(0x1)标志,若设置,位0表示该帧确认接收和应用对等设备帧,当该位设置时,SETTINGS帧的有效载荷必须为空,收到一个设置了ACK标志并且长度字段值不为0的SETTINGS帧必须被视为FRAME_SIZE_ERROR类型的连接错误SETTINGS帧始终适用于连接,而不是单个流,设置帧的流标识必须为零(0x0),如果端点收到SETTINGS帧,其流标识符字段不是0x0,那么端点必须响应一个类型为PROTOCOL_ERROR的连接错误SETTINGS帧影响连接状态,错误格式或不完整的SETTINGS帧必须被视为类型为PROTOCOL_ERROR的连接错误- 长度不是
6个字节倍数的SETTINGS帧必须被视为FRAME_SIZE_ERROR类型的连接错误
Settings 同步
SETTINGS中的大部分值受益于或需要了解对等体何时接收并应用更改的参数值,为了提供这样的同步时间点,其中未设置ACK标志的SETTINGS帧的接收方必须在收到后尽快应用更新的参数SETTINGS帧中的值必须按照它们出现的顺序进行处理,值之间没有其他帧处理,不支持的参数必须被忽略,一旦所有值都被处理完毕,接收者必须立即发出一个设置了ACK标志的SETTINGS帧, 一旦接收到设置了ACK标志的SETTINGS帧,改变参数的发送者就可以依赖已经应用的设置- 如果
SETTINGS帧的发送者在合理的时间内没有收到确认,它可能会发出SETTINGS_TIMEOUT类型的连接错误
PUSH_PROMISE 帧
PUSH_PROMISE 帧(type = 0x5)用于在发送者打算初始化流之前通知对端,PUSH_PROMISE 帧包括端点计划创建的流的无符号 31 位标识符以及为流提供附加上下文的一组 Header
1 | +---------------+ |
| 名称 | 解释 |
|---|---|
Pad Length |
填充长度 |
R |
一个保留位 |
Promised Stream ID |
一个无符号的31位整数,用于标识由PUSH_PROMISE 保留的流,承诺流标识符必须是发送方发送的下一个流的有效选择 |
Header Block Fragment |
包含请求头部字段的 Header 块片段 |
Padding |
填充字节 |
标志
END_HEADERS(0x4),置位时,位2指示该帧包含整个Header块,并且没有任何CONTINUATION帧,没有设置END_HEADERS标志的PUSH_PROMISE帧必须跟着同一个流的CONTINUATION帧,接收方必须将接收到的任何其他类型的帧或不同流上的帧视为类型为PROTOCOL_ERROR的连接错误PADDED(0x8),置位时,位3指示Pad Length字段及其描述的填充符存在
说明
PUSH_PROMISE帧必须只能在处于open或Half-Closed (remote)状态的已对端初始化的流上发送,PUSH_PROMISE帧的流标识符指示与其关联的流,如果流标识符字段指定值0x0,则接收方必须响应类型为PROTOCOL_ERROR的连接错误- 承诺的流不需要按照承诺的顺序使用,
PUSH_PROMISE仅保留流标识符供以后使用 - 如果对端端点的
SETTINGS_ENABLE_PUSH设置被设置为0,则不应发送PUSH_PROMISE,已设置此设置并已收到确认的端点务必将PUSH_PROMISE帧的接收视为类型为PROTOCOL_ERROR的连接错误 PUSH_PROMISE帧的接受者可以选择拒绝承诺的流,通过发送带有承诺的流标识符的RST_STREAM返回给PUSH_PROMISE的发送者来
PING 帧
PING 帧(type = 0x6)是一种机制,用于测量来自发送方的最小往返时间,以及确定空闲连接是否仍然有效,PING 帧可以从任何端点发送
1 | +---------------------------------------------------------------+ |
除帧头外,PING 帧必须在有效载荷中包含 8 个不透明数据字节,发送者可以包含它选择的任何值,并以任何方式使用这些八位字节,不包括 ACK 标记的 PING 帧的接收者务必发送一个 PING 帧,并在响应中设置 ACK 标志,并使用相同的有效载荷,PING 响应应该被赋予比任何其他帧更高的优先级
标志
ACK(0x1),置位时,位 0 表示该 PING 帧是 PING 响应,端点必须在 PING 响应中设置这个标志,端点不能响应包含这个标志的 PING 帧
说明
PING 帧不与任何独立的流关联,如果接收到流标识符字段不是 0 的PING 帧,接收者必须以类型是 PROTOCOL_ERROR 的连接错误来响应,接收到长度字段的值不是 8 的 PING 帧,则必须被作为类型是 FRAME_SIZE_ERROR 的连接错误
GOAWAY 帧
GOAWAY 帧(type = 0x7)用于启动连接关闭或发出严重错误状态信号,GOAWAY 允许端点正常停止接受新的流,同时仍然完成对先前建立的流的处理,这可以实现管理操作,例如服务器维护,在端点开始新流和端点远程发送 GOAWAY 帧之间存在固有的竞争条件,为了处理这种情况,GOAWAY 包含在此连接中的发送端点上已处理或可能处理的最后一个 Peer-initiated 流的流标识符,例如,如果服务器发送 GOAWAY 帧,则标识的流是由客户端发起的编号最大的流
一旦发送,如果流的标识符高于包含的最后流标识符,则发送方将忽略由接收方发起的流上发送的帧,GOAWAY 帧的接收者不能在连接上打开额外的流,尽管可以为新的流建立新的连接,如果 GOAWAY 的接收者已经发送了具有比 GOAWAY 帧更高的流标识符的流的数据,那么这些流不被处理或将不被处理,GOAWAY 帧的接收者可以将这些流视为从未被创建,从而允许这些流稍后在新连接上重试
端点应该总是在关闭连接之前发送一个 GOAWAY 帧,以便远程节点可以知道流是否已被部分处理,例如,如果 HTTP 客户端在服务器关闭连接的同时发送 POST,则客户端无法知道服务器是否开始处理该 POST 请求,如果服务器未发送 GOAWAY 帧来指示它可能具有哪些流采取行动,对于行为不当的对端,端点可以选择关闭连接而不发送 GOAWAY
GOAWAY 帧可能不会立即关闭连接之前,GOAWAY 的接收器不再用于连接应该在终止连接之前仍然发送 GOAWAY 帧
1 | +-+-------------------------------------------------------------+ |
标志
GOAWAY 帧不定义任何标记
说明
GOAWAY帧适用于连接,而不是特定的流,端点必须将带有0x0以外的流标识符的GOAWAY帧视为类型为PROTOCOL_ERROR的连接错误GOAWAY帧还包含一个32位错误代码,其中包含关闭连接的原因,端点可以将不透明数据附加到任何GOAWAY帧的有效载荷,额外的调试数据仅用于诊断目的,并没有语义值,调试信息可能包含安全或隐私敏感数据,记录或以其他方式持久存储的调试数据必须有足够的安全措施以防止未经授权的访问,
CONTINUATION 帧
CONTINUATION 帧(type = 0x9)被用于继续发送 Header 块片段的序列,只要相同流上的前导帧是没有设置 END_HEADERS 标记的 HEADERS,PUSH_PROMISE 或 CONTINUATION 帧,就可以发送任意数量的 CONTINUATION 帧
1 | +---------------------------------------------------------------+ |
CONTINUATION 帧有效载荷包含一个 Header 块片段
标志
CONTINUATION 帧定义了以下标志
END_HEADERS(0x4),置位时,位2表示该帧结束Header块,如果未设置END_HEADERS位,则该帧必须紧跟着另一个CONTINUATION帧,接收方必须将接收到的任何其他类型的帧或不同流上的帧视为PROTOCOL_ERROR类型的连接错误
说明
CONTINUATION帧必须与流相关联,如果收到其流标识符字段为0x0的CONTINUATION帧,接收方必须响应PROTOCOL_ERROR类型的连接错误CONTINUATION帧必须在前面加上HEADERS,PUSH_PROMISE或CONTINUATION帧,而不要设置END_HEADERS标志,观察到违反此规则的接受者必须响应PROTOCOL_ERROR类型的连接错误
流
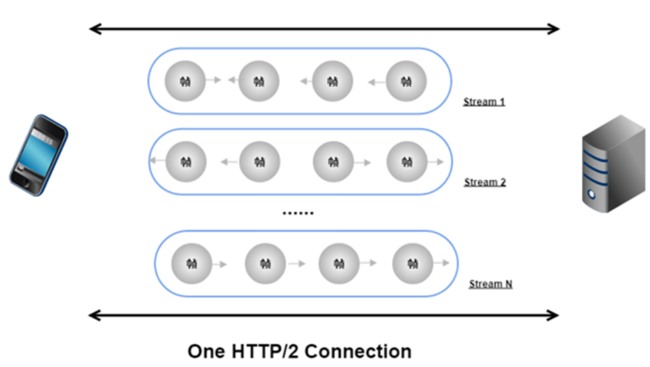
HTTP/2 规范对流的定义是,HTTP/2 连接上独立的、双向的帧序列交换,因为在客户端与服务器之间,双方都可以互相发送二进制帧,这样的双向传输的序列就可以称为流,你也可以将流看作在连接上的一系列帧,它们构成了单独的 HTTP 请求和响应,如果客户端想要发出请求,它会开启一个新的流,然后服务器将在这个流上回复,这与 请求/响应 的流程很类似,重要的区别在于,因为有分帧,所以多个请求和响应可以交错,而不会互相阻塞
流具有一些重要的特性
- 单个的
HTTP/2连接可以包含多个并发打开的流,各个终端多个流的帧可以交叉 - 流可以单方面地建立和使用,或由客户端或服务器共享
- 流可以被任何一端关闭
- 流中帧的发送顺序是值得注意的,接收者以它们收到帧的顺序处理,特别的,
HEADERS帧和DATA帧在语义上是非常重要的 - 流由一个整数标识,流标识符由发起流的终端来赋值
这里也存在一个问题,那就是乱序的二进制帧,是如何组装成对于的报文呢?
- 所谓的乱序,指的是不同
ID的Stream是乱序的,对于同一个Stream ID的帧是按顺序传输的 - 接收方收到二进制帧后,将相同的
Stream ID组装成完整的请求报文和响应报文 - 二进制帧中有一些字段,控制着优先级和流量控制等功能,这样就可以设置数据帧的优先级,让服务器处理重要资源,优化用户体验
流的生命周期
流的生命周期如下所示
1 | +--------+ |
这里需要注意的是,此图显示了流状态转换以及会影响这些转换的帧和标志,在这方面,CONTINUATION 帧不会导致状态转换,实际上是它们跟随的 HEADERS 或 PUSH_PROMISE 的一部分,出于状态转换的目的,END_STREAM 标志作为单独的事件处理到承载它的帧,具有 END_STREAM 标志设置的 HEADERS 帧可以导致两个状态转换
两个端点都有流状态的主观视图,当帧在传输过程中可能会有所不同,端点不协调创建流,它们是由任一端点单方面创建的,在发送 RST_STREAM 之后,状态不匹配的负面影响仅限于 Closed 状态,在关闭后帧可能会被接收一段时间
流的状态
数据流具有以下状态
idle
所有的流都以 idle 状态开始,以下转换在此状态下有效
- 发送或接收
HEADERS帧会导致流成为open,同样HEADERS帧也可以使流立即变成Half-Closed - 在另一个流上发送
PUSH_PROMISE帧将保留标识的空闲流为以后使用,保留流的流状态转换为Reserved (local) - 在另一个流上接收
PUSH_PROMISE帧将保留标识的空闲流为以后使用,保留流的流状态转换为Reserved (remote) - 特别注意,
PUSH_PROMISE帧不在空闲流上发送,而是在Promised Stream ID字段中引用新保留的流
在 idle 状态下,在流上接收除 HEADERS 或 PRIORITY 之外的任何帧必须被视为类型为 PROTOCOL_ERROR 的连接错误
Reserved (local)
处于 Reserved (local) 状态的流是通过发送 PUSH_PROMISE 帧来承诺的流,PUSH_PROMISE 帧通过将流与远程对等端发起的开放流关联来保留 idle 流,在这种状态下,只有以下转换是可能的
- 端点可以发送
HEADERS帧,这会导致流开启为Half-Closed (remote)状态 - 任一端点都可以发送
RST_STREAM帧,以使流成为Closed,这将释放流预留
在此状态下,端点不得发送除 HEADERS,RST_STREAM 或 PRIORITY 之外的任何类型的帧,可以在此状态下接收 PRIORITY 或 WINDOW_UPDATE 帧,在此状态的流上接收除 RST_STREAM,PRIORITY 或 WINDOW_UPDATE 以外的任何类型的帧必须视为 PROTOCOL_ERROR 类型的连接错误
Reserved (remote)
处于 Reserved (remote) 状态的流已被远程对端保留,在这种状态下,只有以下转换是可能的
- 接收
HEADERS帧会导致数据流转换为Half-Closed (local) - 任一端点都可以发送
RST_STREAM帧,以使流成为Closed,这将释放流预留
端点可以在这种状态下发送 PRIORITY 帧来重新设置保留流的优先级,在此状态下,端点不得发送除 RST_STREAM,WINDOW_UPDATE 或 PRIORITY 以外的任何类型的帧,在这种状态下,在流上接收除 HEADERS,RST_STREAM 或 PRIORITY 以外的任何类型的帧必须被视为类型为 PROTOCOL_ERROR 的连接错误
open
处于open状态的流可以被两个对端用来发送任何类型的帧,在这种状态下,发送对等方遵守流级别的流量控制限制,
在这种状态下,任何端点都可以发送带有 END_STREAM 标志的帧,这会导致流转换到 Half-Closed 状态之一,发送 END_STREAM 标志的端点导致流状态变为 Half-Closed (local),接收 END_STREAM 标志的端点将导致流状态变为 half-close (remote),每个端点都可以从此状态发送 RST_STREAM 帧,使其立即转换为Closed
Half-Closed (local)
处于 Half-Closed (local) 状态的流不能用于发送 WINDOW_UPDATE,PRIORITY 和 RST_STREAM 以外的帧,当接收到包含 END_STREAM 标志的帧或任一对端发送 RST_STREAM 帧时,流将从此状态转换为 Closed 状态
端点可以在这种状态下接收任何类型的帧,使用 WINDOW_UPDATE 帧提供流量控制信用是继续接收流量控制帧所必需的,在这种状态下,接收方可以忽略 WINDOW_UPDATE 帧,因为带有 END_STREAM 标志的帧可能会在短时间内到达,在此状态下收到的优先级帧用于重新确定依赖于已识别流的流的优先级
Half-Closed (remote)
Half-Closed (remote) 的流不再被对端用来发送帧,在这种状态下,端点不再需要维护接收器流量控制窗口,如果端点接收到除 WINDOW_UPDATE,PRIORITY 或 RST_STREAM 之外的其他帧,则对于处于此状态的流,它必须响应类型为 STREAM_CLOSED 的流错误
Half-Closed (remote) 的流可以被端点用来发送任何类型的帧,在这种状态下,端点会继续观察流级别的流量控制限制,通过发送一个包含 END_STREAM 标志的帧或任一对端发送 RST_STREAM 帧,流可以从此状态转换为 Closed 状态
Closed
Closed 状态是终结状态,端点不得在封闭流上发送 PRIORITY 以外的帧,在接收到 RST_STREAM 后接收除 PRIORITY 以外的任何帧的端点必须将其视为类型 STREAM_CLOSED 的流错误,类似地,在接收到设置了 END_STREAM 标志的帧后接收任何帧的端点必须将其视为 STREAM_CLOSED 类型的连接错误,除非该帧是允许的,如下所述
WINDOW_UPDATE或RST_STREAM帧可以在包含END_STREAM标志的DATA或HEADERS帧发送后的短时间内在此状态下接收,在远程节点接收并处理RST_STREAM或带有END_STREAM标志的帧之前,它可能会发送这些类型的帧,终端必须忽略在这种状态下接收到的WINDOW_UPDATE或RST_STREAM帧,当然终端也可以选择将在发送END_STREAM相当长时间之后到达的帧作为类型为PROTOCOL_ERROR的连接错误PRIORITY帧可以在Closed流上发送,以设置依赖于这个Closed流的其他流的优先级,端点应该处理PRIORITY帧,当然如果流已经从依赖关系树中移除,则它们可以被忽略- 如果由于发送
RST_STREAM帧而达到此状态,那么接收RST_STREAM的对端可能已经在流上发送或已排队发送帧而无法取消,端点必须在发送RST_STREAM帧后忽略它在Closed流上接收到的帧,端点可以选择限制它忽略帧的时间段,并将在此时间后到达的帧视为错误 - 在发送
RST_STREAM之后接收的适用于流量控制的帧(即DATA)被计数到连接流量控制窗口,即使这些帧可能被忽略,因为它们是在发送者收到RST_STREAM之前发送的,发送者会认为这些帧是针对流量控制窗口进行计数的 - 端点在发送
RST_STREAM后可能会收到一个PUSH_PROMISE帧,即使关联的流已重置,PUSH_PROMISE也会使流成为Reserved,因此,需要RST_STREAM来关闭不需要的承诺流
补充
实现应该将描述中没有明确表示允许的帧的状态的接收作为一个类型为 PROTOCOL_ERROR 的连接错误,注意任何状态下的流都可以发送和接收 PRIORITY,类型未知的帧被忽略
流的标识符
流用无符号的 31 位整数标识
- 客户端发起的流必须使用『奇数』流标识符
- 由服务器发起的必须使用『偶数』流标识符
连接控制消息使用零(0x0)的流标识符,零流标识符不能用于建立新的流,被升级到 HTTP/2 的 HTTP/1.1 请求以流标识符(0x1)响应,升级完成后,
对于客户端来说流 0x1 是 Half-Closed (local),因此,流 0x1 不能被从 HTTP/1.1 升级的客户端选择为新的流标识符
新建立的流的标识符必须在数字上大于发起端点已经打开或保留的所有流,这将控制使用 HEADERS 帧打开的流和使用 PUSH_PROMISE 保留的流,接收到意外流标识符的端点必须响应 PROTOCOL_ERROR 类型的连接错误
新流的标识符的第一次使用隐式地关闭了所有由该对端以低值流标识符发起的处于 idle 状态的流,例如如果客户端在流 7 上发送 HEADERS 帧而没有在流 5 上发送帧,则当流 7 的第一帧被发送或接收时,流 5 转换到 Closed 状态
流标识符不能被重用,长时间连接会导致端点耗尽流标识符的可用范围,无法建立新流标识符的客户端可以为新流建立新连接,无法建立新流标识符的服务器可以发送 GOAWAY 帧,以便强制客户端为新流打开新连接
连接、流和帧的关系
关系如下
- 一个连接同时被多个流复用
- 一个流代表一次完整的 请求/响应 过程,包含多个帧
- 一个消息被拆分封装成多个帧进行传输
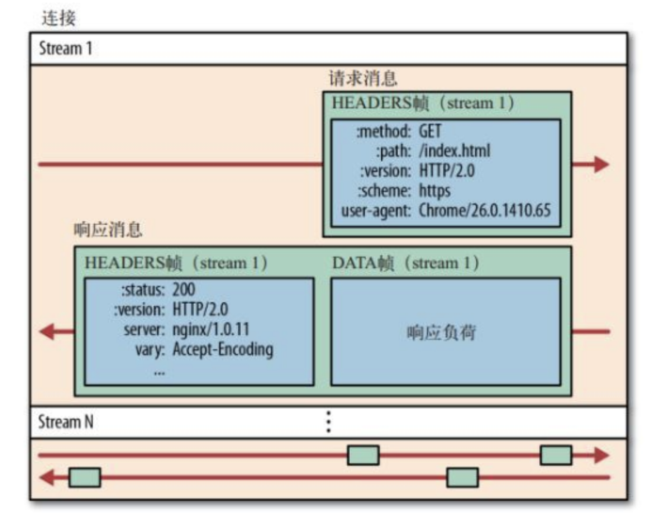
消息
HTTP 消息泛指 HTTP 请求或响应,流是用来传输一对 请求/响应消息的,一个消息至少由 HEADERS 帧(初始化流)组成,并且可以另外包含 CONTINUATION 和 DATA 帧,以及其他的 HEADERS 帧

HTTP/1.1 的请求和响应都分成消息首部和消息体两部分,与之类似 HTTP/2 的请求和响应分成 HEADERS 帧和 DATA 帧,HTTP/1.1 把消息分成两部分 请求/状态行 与 首部,HTTP/2 取消了这种区分,并把这些行变成了伪首部,举个例子,HTTP/1.1 的请求和响应可能是这样的
1 | GET / HTTP/1.1 |
在 HTTP/2 中,它等价于
1 | :scheme: https:method: GET |
请注意,请求和状态行在这里拆分成了多个首部,即 :scheme、:method、:path 和 :status,同时要注意的是,HTTP/2 的这种表示方式跟数据传输时不同,主要有以下两点
- 没有分块编码(
chunked encoding),在基于帧的世界里,只有在无法预先知道数据长度的情况下向对方发送数据时,才会用到分块,在使用帧作为核心协议的HTTP/2里,就不再需要它了 - 不再有
101的响应,Switching Protocol响应是HTTP/1.1的边缘应用,它如今最常见的应用可能就是用以升级到WebSocket连接,ALPN提供了更明确的协议协商路径,往返的开销也更小
流量控制
HTTP/2 的新特性之一是基于流的流量控制,不同于 HTTP/1.1 的世界,只要客户端可以处理,服务端就会尽可能快地发送数据,HTTP/2 提供了客户端调整传输速度的能力,WINDOW_UPDATE 帧用来指示流量控制信息,每个帧告诉对方,发送方想要接收多少字节
客户端有很多理由使用流量控制,一个很现实的原因可能是,确保某个流不会阻塞其他流,也可能客户端可用的带宽和内存比较有限,强制数据以可处理的分块来加载反而可以提升效率,尽管流量控制不能关闭,把窗口最大值设定为设置 2^31 - 1 就等效于禁用它,至少对小于 2GB 的文件来说是如此
另一个需要注意的是中间代理,通常情况下,网络内容通过代理或者 CDN 来传输,也许它们就是传输的起点或终点,由于代理两端的吞吐能力可能不同,有了流量控制,代理的两端就可以密切同步,把代理的压力降到最低
请求优先级
流的最后一个重要特性是依赖关系,现代浏览器都经过了精心设计,首先请求网页上最重要的元素,以最优的顺序获取资源,由此来优化页面性能,拿到了 HTML 之后,在渲染页面之前,浏览器通常还需要 CSS 和 JavaScript 这样的东西,在没有多路复用的时候,在它可以发出对新对象的请求之前,需要等待前一个响应完成
有了 HTTP/2,客户端就可以一次发出所有资源的请求,服务端也可以立即着手处理这些请求,由此带来的问题是,浏览器失去了在 HTTP/1.1 时代默认的资源请求优先级策略,假设服务器同时接收到了 100 个请求,也没有标识哪个更重要,那么它将几乎同时发送每个资源,次要元素就会影响到关键元素的传输
HTTP/2 通过流的依赖关系来解决这个问题,通过 HEADERS 帧和 PRIORITY 帧,客户端可以明确地和服务端沟通它需要什么,以及它需要这些资源的顺序,这是通过声明依赖关系树 和树里的相对权重实现的
- 依赖关系为客户端提供了一种能力,通过指明某些对象对另一些对象有依赖,告知服务器这些对象应该优先传输
- 权重让客户端告诉服务器如何确定具有共同依赖关系的对象的请求优先级
我们来看看这个简单的网站
1 | index.html |
在收到主体 HTML 文件之后,客户端会解析它,并生成依赖树,然后给树里的元素分配权重,这时这棵树可能是这样的
1 | index.html |
在这个依赖树里,客户端表明它最需要的是 style.css,其次是 critical.js,没有这两个文件,它就不能接着渲染页面,等它收到了 critical.js,就可以给出其余对象的相对权重,权重表示服务一个对象时所需要花费时间的重要程度
HTTP/2 主要改动
HTTP/2 作为新版协议,改动细节必然很多,不过对应用开发者和服务提供商来说,影响较大的有以下这些
多路复用
多路复用允许同时通过单一的 HTTP/2 连接发起多重的 请求/响应 消息,众所周知在 HTTP/1.1 协议中,浏览器客户端在同一时间,针对同一域名下的请求有一定数量限制,超过限制数目的请求会被阻塞,也就是如果想并发多个请求,必须使用多个 TCP 链接
这也是为何一些站点会有多个静态资源 CDN 域名的原因之一,目的就是变相的解决浏览器针对同一域名的请求限制阻塞问题,而 HTTP/2 的多路复用(Multiplexing)则允许同时通过单一的 HTTP/2 连接发起多重的 请求/响应 消息
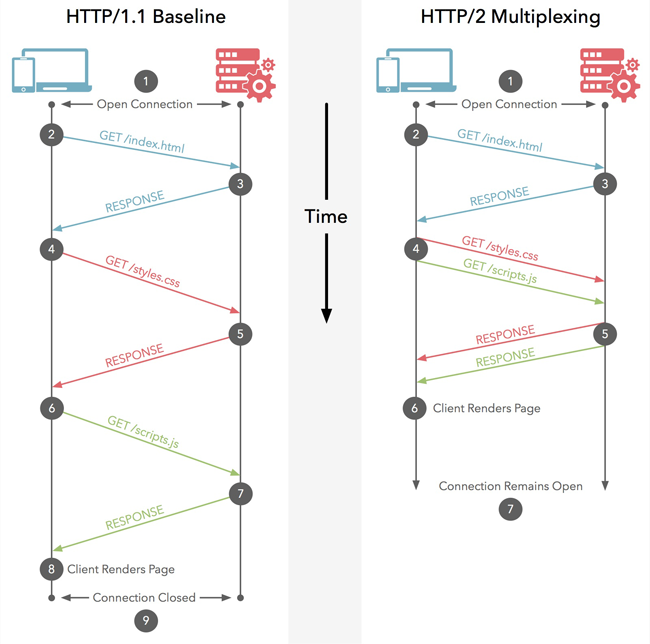
因此 HTTP/2 可以很容易的去实现多流并行而不用依赖建立多个 TCP 连接,HTTP/2 把 HTTP 协议通信的基本单位缩小为一个一个的帧,这些帧对应着逻辑流中的消息,并行地在同一个 TCP 连接上双向交换消息
关于多路复用的特点与好处,简单总结就是
- 同域名下所有通信都在单个连接上完成,单个连接可以承载任意数量的双向数据流
- 数据流以消息的形式发送,而消息又由一个或多个帧组成,多个帧之间可以乱序发送,因为根据帧首部的流标识可以重新组装,也就是
Stream ID,流标识符,有了它,接收方就能从乱序的二进制帧中选择ID相同的帧,按照顺序组装成请求/响应报文 - 减少服务端连接压力,减少占用内存,提升连接吞吐量
- 连接数的减少改善了网络拥塞状况,慢启动时间减少,拥塞和丢包恢复速度更快
- 避免连接频繁创建和关闭(三次连接、四次挥手)
首部压缩(Header Compression)
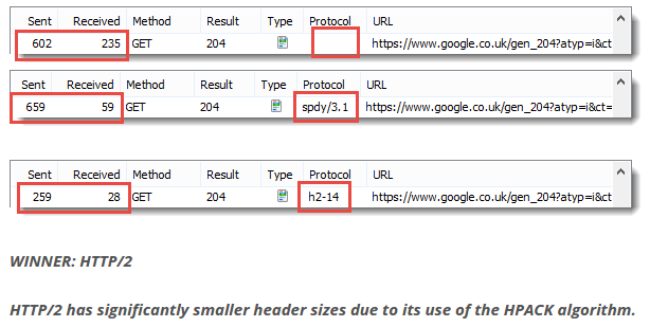
现代网页平均包含 140 个请求,每个 HTTP 请求平均有 460 字节,总数据量达到 63KB,即使在最好的环境下,这也会造成相当长的延时,如果考虑到拥挤的 Wi-Fi 或连接不畅的蜂窝网络,那可是非常痛苦的,这些请求之间通常几乎没有新的或不同的内容,这才是真正的浪费,所以大家迫切渴望某种类型的压缩
HTTP/1.1 并不支持 HTTP 首部压缩,为此 SPDY 和 HTTP/2 应运而生,SPDY 使用的是通用的 DEFLATE 算法,而 HTTP/2 则使用了专门为首部压缩而设计的 HPACK 算法
比如下面这两个请求
1 | :authority: www.example.com |
1 | :authority: www.example.com |
可以看到,后者的很多数据与前者重复了,第一个请求约有 220 字节,第二个约有 230 字节,但二者只有 36 字节是不同的,如果仅仅发送这 36 字节,就可以节省约 85% 的字节数,简而言之,HPACK 的原理就是这样,下面我们简单的来看看 HPACK 算法是什么样的,如下图所示

从上面看,我们可以看到类似于索引表,每个索引表对应一个值,比如索引为 2 对应头部中的 Method 头部信息,这样的话,在传输的时候,不在是传输对应的头部信息了,而是传递索引,对于之前出现过的头部信息,只需要把索引传给对方,对方拿到索引查表即可
这种传索引的方式,可以说让请求头字段得到极大程度的精简和复用,其次是对于整数和字符串进行哈夫曼编码,哈夫曼编码的原理就是先将所有出现的字符建立一张索引表,然后让出现次数多的字符对应的索引尽可能短,传输的时候也是传输这样的索引序列,可以达到非常高的压缩率
最后我们再来看一个问题,那就是为什么不使用 GZIP 压缩,而去使用专门为首部压缩而设计的 HPACK 算法呢?
GZIP也有泄漏加密信息的风险(CRIME攻击),CRIME的原理是这样的,攻击者在请求中添加数据,观察压缩加密后的数据量是否会小于预期,如果变小了,攻击者就知道注入的文本和请求中的其他内容(比如私有的会话Cookie)有重复,在很短的时间内,经过加密的数据内容就可以全部搞清楚,因此大家放弃了已有的压缩方案,研发出HPACK
服务端推送(Server Push)
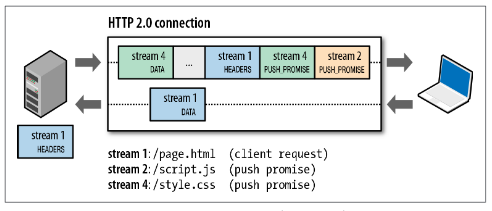
提升单个对象性能的最佳方式,就是在它被用到之前就放到浏览器的缓存里面,这正是 HTTP/2 的服务端推送的目的,推送使服务器能够主动将对象发给客户端,这可能是因为它知道客户端不久将用到该对象
如果服务器决定要推送一个对象(RFC 中称为推送响应),会构造一个 PUSH_PROMISE 帧,它的用处有很多
PUSH_PROMISE帧首部中的流ID用来响应相关联的请求,推送的响应一定会对应到客户端已发送的某个请求,如果浏览器请求一个主体HTML页面,如果要推送此页面使用的某个JavaScript对象,服务器将使用请求对应的流ID构造PUSH_PROMISE帧PUSH_PROMISE帧的首部块与客户端请求推送对象时发送的首部块是相似的,所以客户端有办法放心检查将要发送的请求- 被发送的对象必须确保是可缓存的
Method首部的值必须确保安全,安全的方法就是幂等的那些方法,这是一种不改变任何状态的好办法,例如GET请求被认为是幂等的,因为它通常只是获取对象,而POST请求被认为是非幂等的,因为它可能会改变服务器端的状态- 理想情况下
PUSH_PROMISE帧应该更早发送,应当早于客户端接收到可能承载着推送对象的DATA帧,假设服务器要在发送PUSH_PROMISE之前发送完整的HTML,那客户端可能在接收到PUSH_PROMISE之前已经发出了对这个资源的请求,HTTP/2足够健壮,可以优雅地解决这类问题,但还是会有些浪费 PUSH_PROMISE帧会指示将要发送的响应所使用的流ID
其实简单来说就是客户端会从
1开始设置流ID,之后每新开启一个流,就会增加2,之后一直使用奇数,服务器开启在PUSH_PROMISE中标明的流时,设置的流ID从2开始,之后一直使用偶数,这种设计避免了客户端和服务器之间的流ID冲突,也可以轻松地判断哪些对象是由服务端推送的,0是保留数字,用于连接级控制消息,不能用于创建新的流
如果客户端对 PUSH_PROMISE 的任何元素不满意,就可以按照拒收原因选择重置这个流(使用 RST_STREAM),或者发送 PROTOCOL_ERROR(在 GOAWAY 帧中),常见的情况是缓存中已经有了这个对象,而 PROTOCOL_ERROR 是专门留给 PUSH_PROMISE 涉及的协议层面问题的,比如方法不安全,或者当客户端已经在 SETTINGS 帧中表明自己不接受推送时,仍然进行了推送,值得注意的是,服务器可以在 PUSH_PROMISE 发送后立即启动推送流,因此拒收正在进行的推送可能仍然无法避免推送大量资源,推送正确的资源是不够的,还需要保证只推送正确的资源,这是重要的性能优化手段
所以到底如何选择要推送的资源?决策的过程需要考虑到如下方面
- 资源已经在浏览器缓存中的概率
- 从客户端看来,这些资源的优先级
- 可用的带宽,以及其他类似的会影响客户端接收推送的资源
如果用户第一次访问页面时,就能向客户端推送页面渲染所需的关键 CSS 和 JavaScript 资源,那么服务端推送的真正价值就实现了,不过这要求服务器端实现足够智能,以避免推送承诺(push promise)与主体 HTML 页面传输竞争带宽

相比较 HTTP/1.1 的优势
- 推送资源可以由不同页面共享
- 服务器可以按照优先级推送资源
- 客户端可以缓存推送的资源
- 客户端可以拒收推送过来的资源
关于服务端推送,有一个常见的问题,那就是如果客户端早已在缓存中有了一份副本该怎么办?
因为 Push 本身具有投机性,所以肯定会出现推送过去的东西浏览器不需要的情况,这种情况下 HTTP/2 允许客户端通过 RESET_STREAM 主动取消 Push,然而这样的话,原本可以用于更好方向的 Push 就白白的浪费掉数据往返的价值
对此,一个推荐的解决方案是,客户端使用一个简洁的 Cache Digest 来告诉服务器,哪些东西已经在缓存,因此服务器也就会知道哪些是客户端所需要的,因为 Cache Digest 使用的是 Golumb Compressed Sets,浏览器客户端可以通过一个连接发送少于 1K 字节的 Packets 给服务端,通知哪些是已经在缓存中存在的
Cache Digests 只是其中一个提案之一, 在 HTTP 社区有着更多其他的解决方案,我们也希望在不久的将来看到他们的身影
HTTP/2 反模式
HTTP/1.1 下的一些性能调优办法在 HTTP/2 下会起到反作用
域名拆分
域名拆分是为了利用浏览器对每个域名开启多个连接的能力,以便实现资源的并行下载,绕过 HTTP/1.1 的串行化下载的限制,对于包含大量小型资源的网站,普遍的做法是拆分域名,以利用现代浏览器针能对每个域名开启 6 个连接的特性,这样实际上做到了让浏览器并行发送多个请求,以及充分利用可用带宽的效果,因为 HTTP/2 采取多路复用,所以域名拆分就不是必要的了,并且反而会让协议力图实现的目标落空
资源内联
资源内联包括把 JavaScript、样式,甚至图片插入到 HTML 页面中,目的是省掉加载外部资源所需的新连接以及请求响应的时间,然而有些 Web 性能的最佳实践不推荐使用内联,因为这样会损失更有价值的特性,比如缓存,如果有同一个页面上的重复访问,缓存通常可以减少请求数(而且能够加速页面渲染),尽管如此,对那些渲染滚动条以上区域所需的微小资源进行内联处理仍是值得的
事实上有证据表明,在性能较弱的设备上,缓存对象的好处不够多,把内联资源拆分出来并不划算,使用
HTTP/2时的一般原则是避免内联,但是内联也并不一定毫无价值
资源合并
资源合并意味着把几个小文件合并成一个大文件,它与内联很相似,旨在省掉那些加载外部资源的请求响应时间,以及 解码/执行 那些资源所消耗的 CPU 资源,之前针对资源内联的规则同样适用于资源合并,我们可以使用它来合并非常小的文件(1KB 或更小),以及对初始渲染很关键的最简化 JavaScript/CSS 资源
禁用 Cookie 的域名
通过禁用 Cookie 的域名来提供静态资源是一项标准的性能优化最佳实践,尤其是使用 HTTP/1.1 时,你无法压缩首部,而且有些网站使用的 Cookie 大小常常超过单个 TCP 数据包的限度,不过在 HTTP/2 下请求首部使用 HPACK 算法被压缩,会显著减少巨型 Cookie 的字节数(尤其是当它们在先后请求之间保持不变),与此同时禁用 Cookie 的域名需要额外的主机名称,这意味着将开启更多的连接
如果你正在使用禁用
Cookie的域名,以后有机会你可能得考虑消灭它,如果你确实不需要那些域名,最好删掉它们,省一个字节就是一个字节
生成精灵图
目前,生成精灵图仍是一种避免小资源请求过多的技术(你能看到人们乐意做什么来优化 HTTP/1.1),为了生成精灵图,开发者把较小的图片拼合成较大的图片,然后用 CSS 选择图片中某个部分展示出来,依据设备及其硬件图形处理能力的不同,精灵图要么非常高效,要么非常低效,如果用 HTTP/2,最佳实践就是避免生成精灵图,主要原因在于,多路复用和首部压缩去掉了大量的请求开销,即便如此,还是有些场景适合使用精灵图